Query fan-out : Google Research s’attaque aux sous-requêtes redondantes
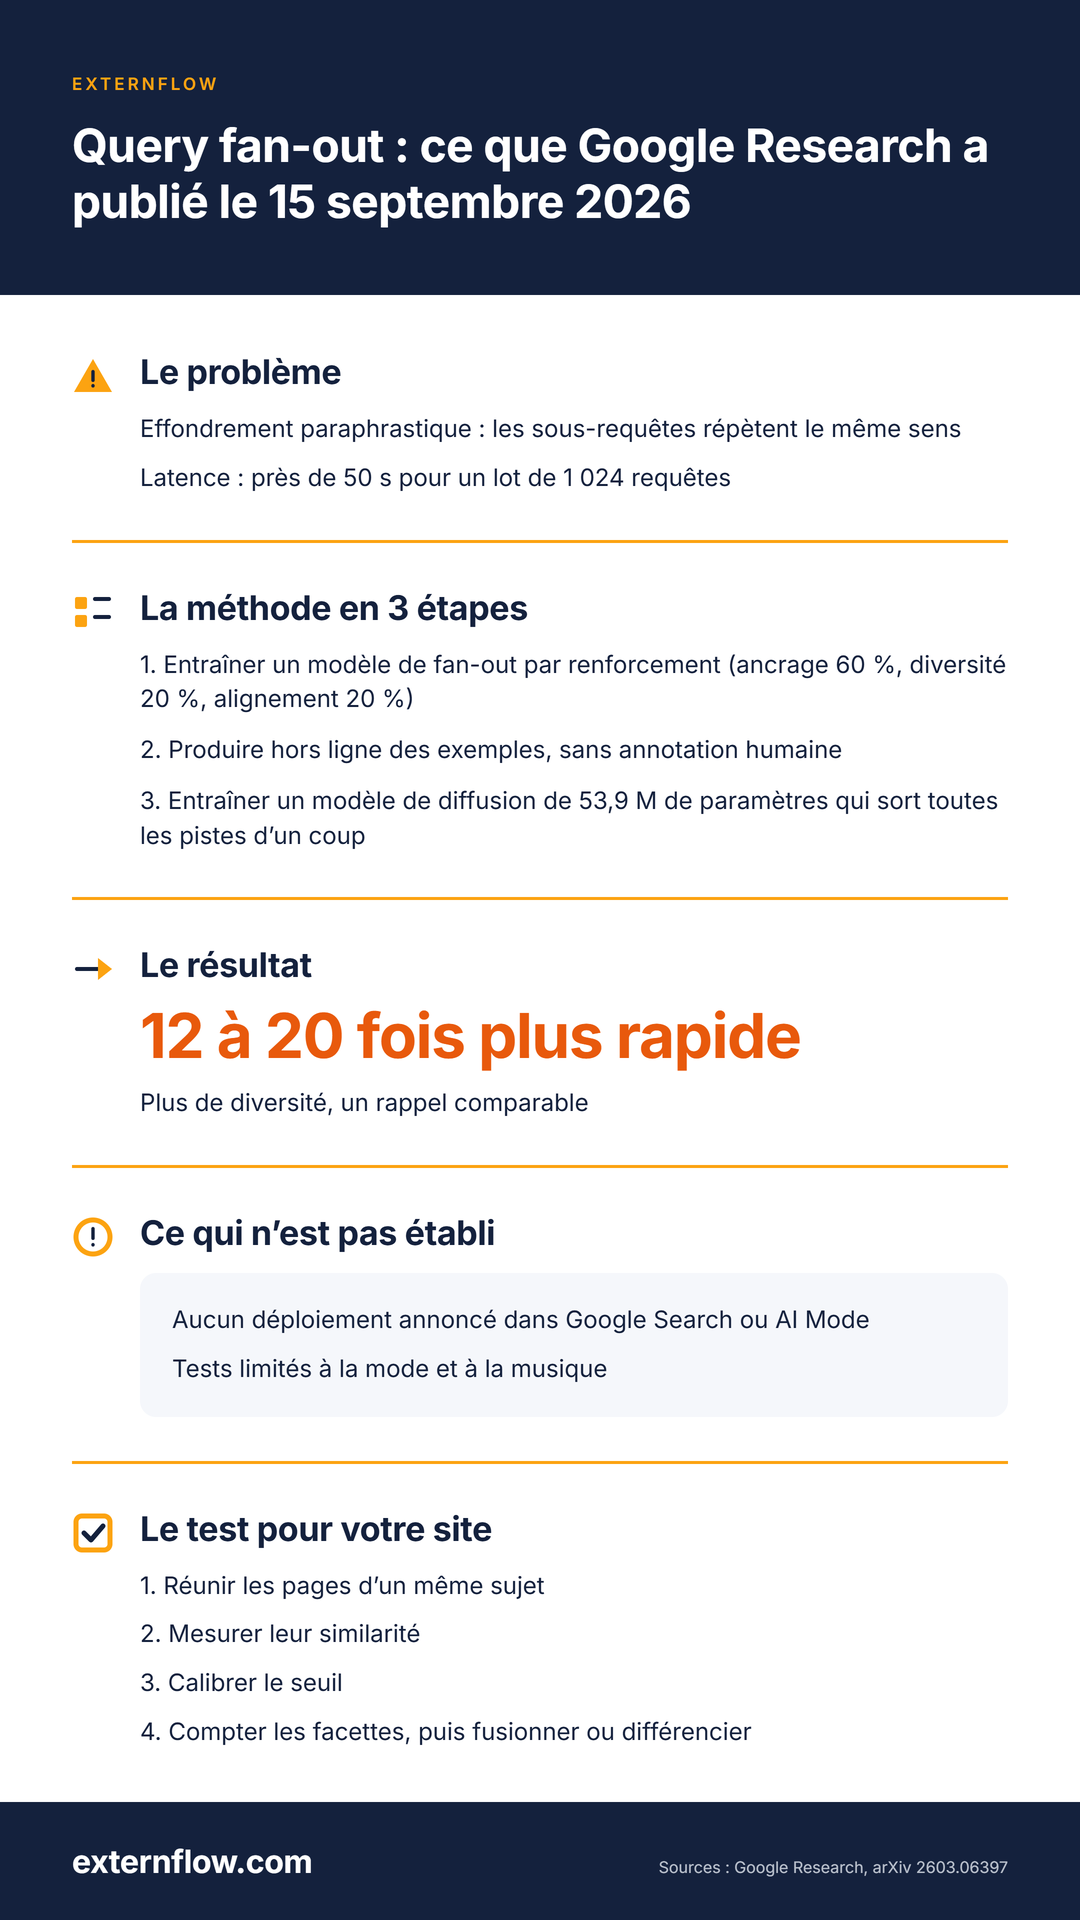
Google Research a présenté le 15 septembre Retrieve-for-Train, une méthode qui décompose une requête large en sous-requêtes complémentaires, douze à vingt fois plus vite qu’un modèle de langage qui rédige ses sous-requêtes mot à mot. La publication ne décrit aucun déploiement dans Google Search. Elle pose pourtant une question éditoriale : que vaut une série de pages qui disent la même chose, quand le moteur cherche des résultats variés ?

Sommaire
- Ce que Retrieve-for-Train corrige dans le query fan-out
- Trois récompenses pour des sous-requêtes complémentaires
- Ce que l’étude ne dit pas sur Google Search
- Sous-requêtes redondantes, pages redondantes : la lecture SEO
- Mesurer la redondance de vos contenus avant d’en commander d’autres
- Externaliser la production sans payer des variantes
- Compter ses facettes avant de commander ses articles
- Sources et références
- FAQ - Questions sur le query fan-out et Retrieve-for-Train
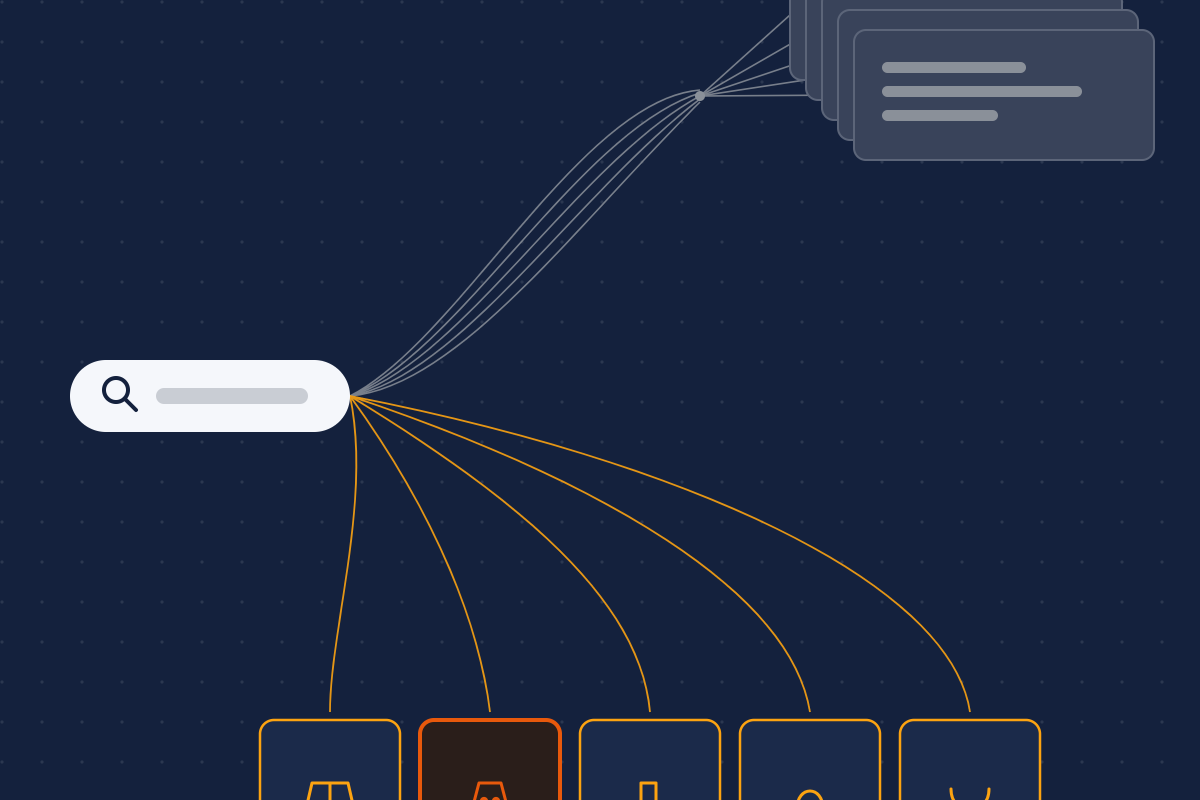
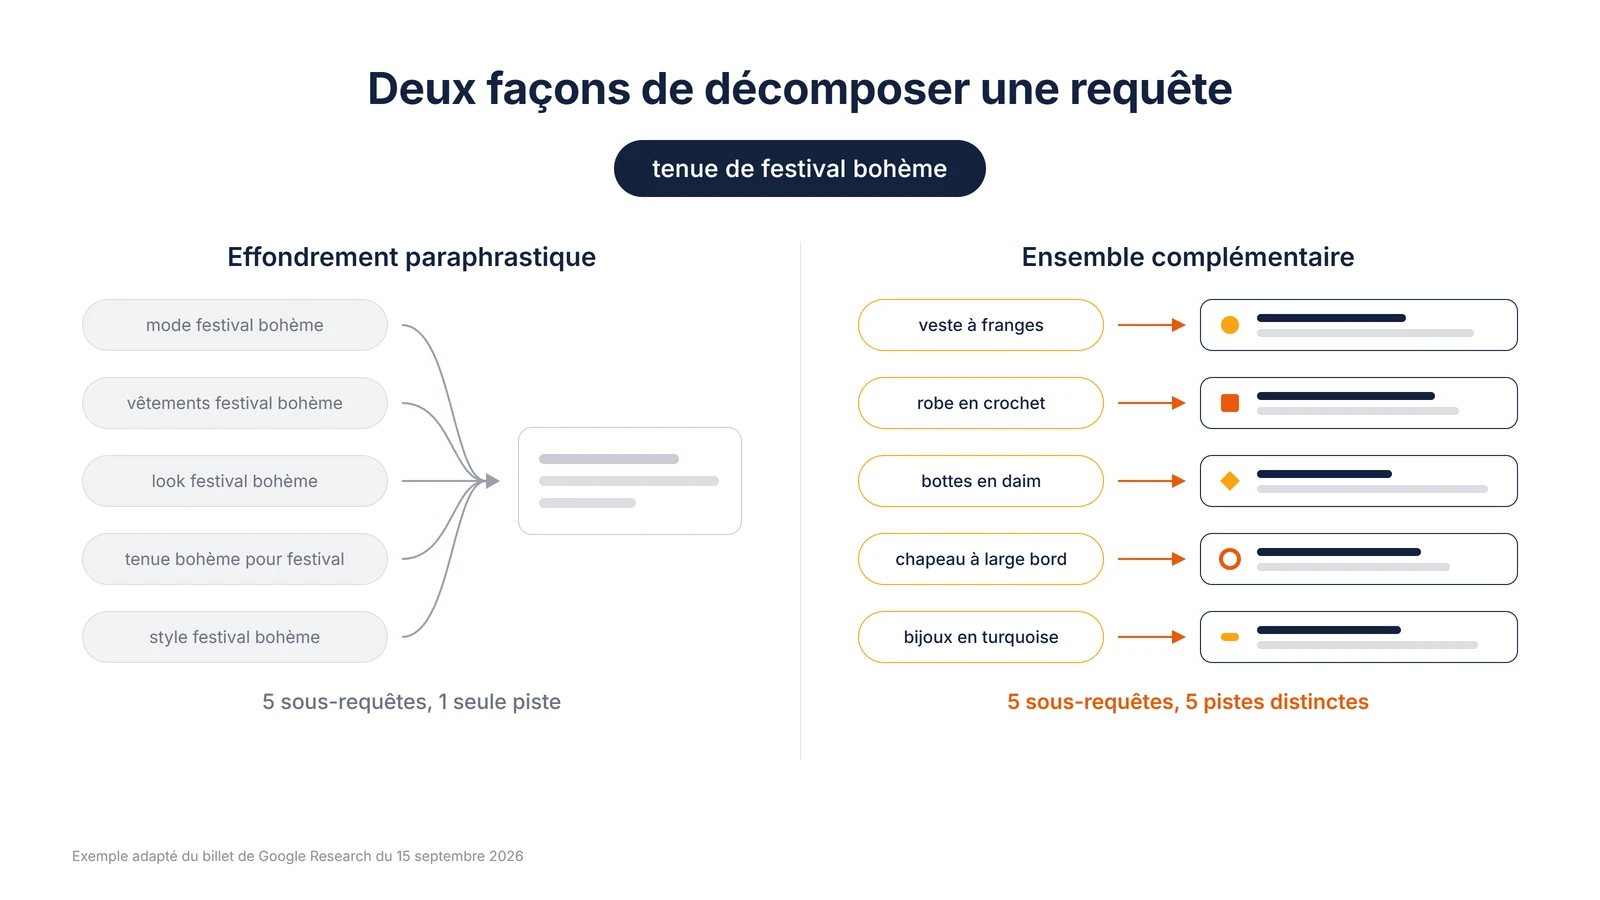
Demandez à un modèle de langage de décomposer la requête « tenue de festival bohème ». Sans entraînement particulier, il propose « mode festival bohème », puis « vêtements festival bohème », puis d’autres variantes du même sens. La veste à franges, la robe en crochet, les bottes en daim ? Il passe à côté.
L’exemple vient d’un billet de Google Research sur le query fan-out. La technique consiste, pour un système d’IA, à découper une requête large en plusieurs recherches lancées en parallèle avant de composer sa réponse. Quand les sous-requêtes se répètent, les résultats se répètent aussi.
La presse spécialisée y a surtout lu une nouvelle sur la vitesse. Pour qui commande des contenus, trois points pèsent davantage : le mécanisme décrit par les chercheurs, ce que leur publication n’établit pas, et un test de redondance à mener sur les pages de votre propre site.
| En bref Retrieve-for-Train apprend à un petit modèle à produire d’un seul coup des pistes de recherche complémentaires, douze à vingt fois plus vite qu’un modèle de langage. Rien n’indique un déploiement dans Google Search. Pour un site, la lecture utile tient en une règle : deux pages qui couvrent la même facette comptent pour une. |
Ce que Retrieve-for-Train corrige dans le query fan-out
Le billet du 15 septembre 2026, signé Pengcheng Jiang et Judith Yue Li, résume un article déposé sur arXiv en mars et présenté à ICML 2026. Onze auteurs, rattachés à Google Research et à l’université de l’Illinois à Urbana-Champaign. Leur méthode s’appelle Retrieve-for-Train, R4T dans l’article, et vise deux défauts.
Le premier est l’effondrement paraphrastique. Un modèle généraliste ne connaît pas la base dans laquelle il cherche. Il reformule donc la demande au lieu d’en explorer les facettes, et ses sous-requêtes quasi synonymes ramènent les mêmes résultats. Dix recherches lancées, et la même piste, dix fois.
Le second défaut est la latence. Avant d’écrire la moindre sous-requête, le modèle rédige des centaines de jetons de raisonnement, mot après mot. Les auteurs jugent ce fonctionnement incompatible avec une réponse en moins d’une seconde, le délai qu’impose une barre de recherche en production.
Trois récompenses pour des sous-requêtes complémentaires
La méthode avance par étapes : entraîner un modèle de langage, lui faire produire des exemples, puis transmettre ce savoir-faire à un modèle bien plus petit. Tout repose sur la notation.
Ancrage, diversité, alignement : le dosage de la récompense
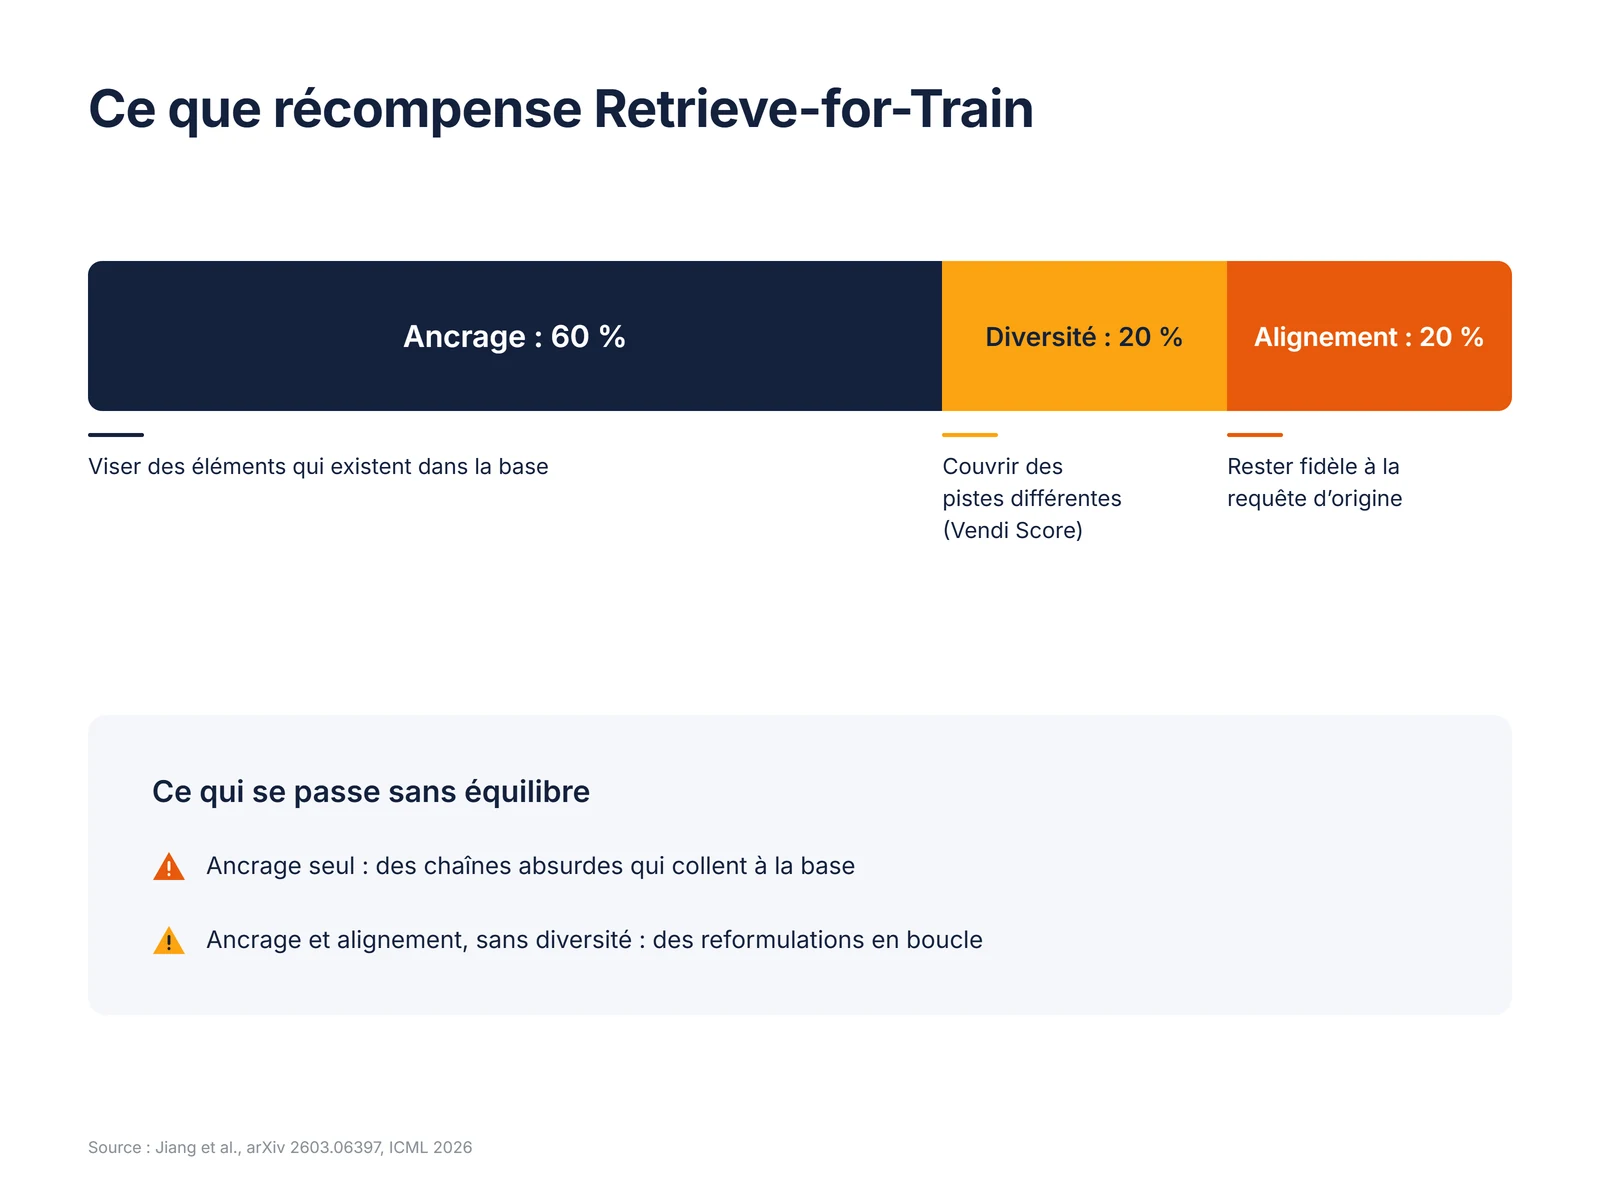
Les chercheurs entraînent par renforcement (méthode Soft-GRPO) deux modèles ouverts de 4 milliards de paramètres, Gemma 3 et Qwen3. Chacun produit dix sous-requêtes par requête. La note porte sur l’ensemble, pas sur chaque sous-requête.
L’ancrage vérifie qu’une sous-requête vise des éléments présents dans la base : il pèse 60 % de la récompense. La diversité mesure l’écart entre les sous-requêtes, pour 20 %. L’alignement les garde fidèles à la requête d’origine, pour 20 % également.
La diversité se calcule avec le Vendi Score (Friedman et Dieng, 2022), qui donne le nombre effectif d’éléments distincts d’un ensemble. Dix sous-requêtes quasi identiques valent environ une.
Retirez un terme et le modèle triche. Noté sur le seul ancrage, il écrit des chaînes absurdes (« line ending line ending ») qui collent aux coordonnées de la base. Ajoutez l’alignement sans la diversité, et il reformule la requête en boucle.
Une seule passe au lieu d’une réflexion mot à mot
Une fois entraîné, ce modèle fabrique hors ligne des paires « requête, ensemble cible », sans annotation humaine. Elles servent à former un modèle de diffusion de 53,9 millions de paramètres. Lui ne passe plus par le texte : il produit d’un coup toutes les directions de recherche, sous forme de vecteurs.
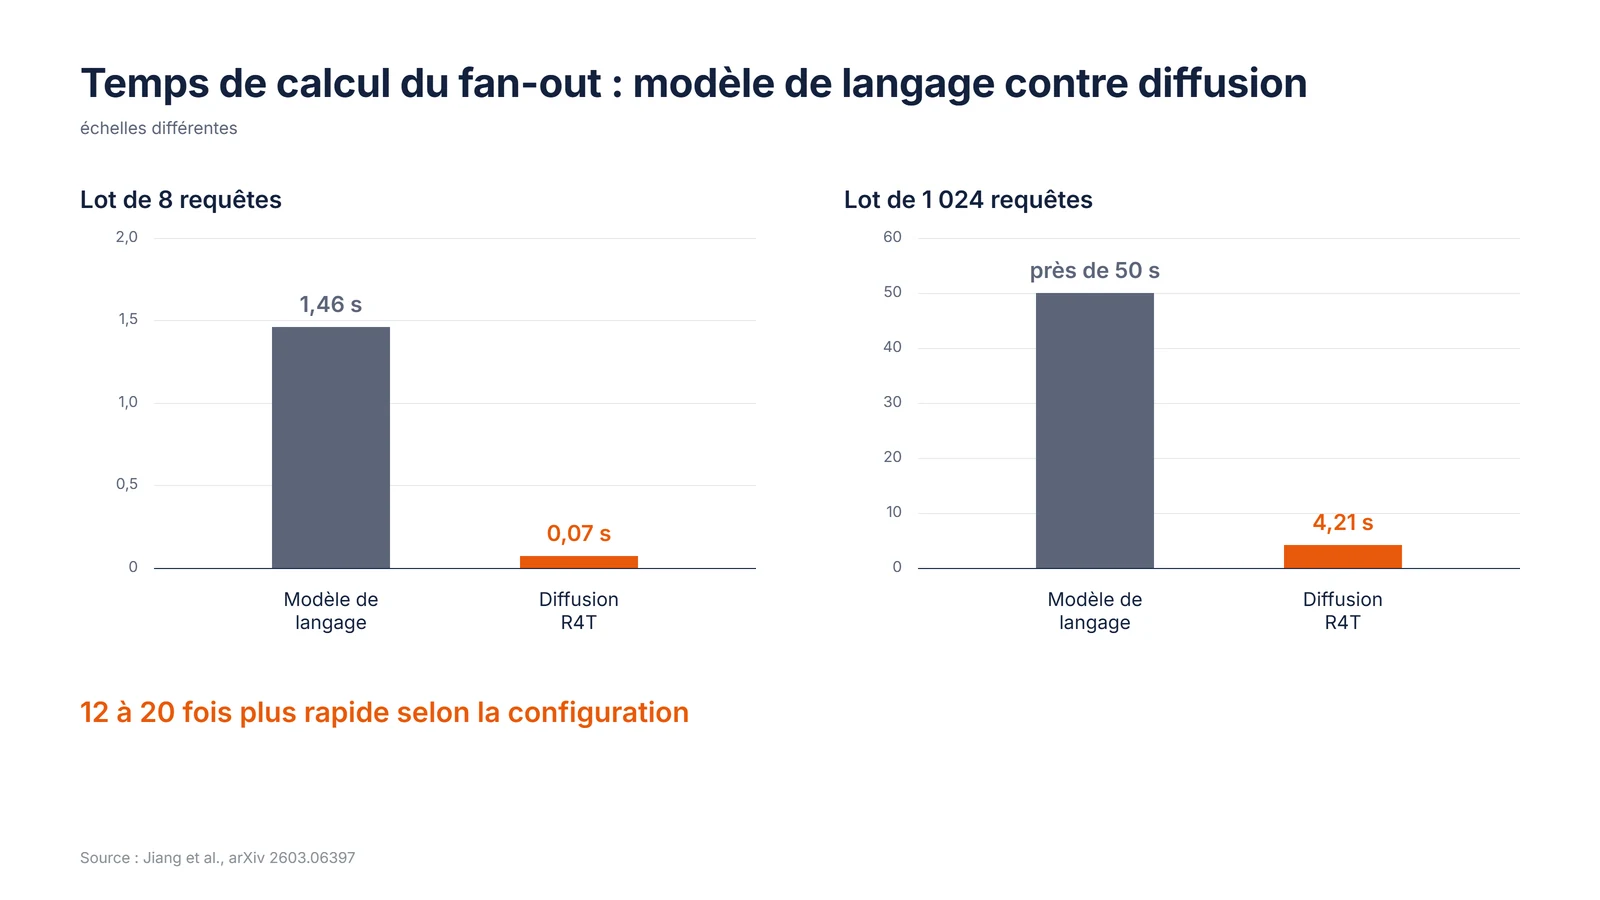
Les mesures publiées : 1,46 seconde pour le modèle de langage contre 0,07 pour la diffusion, sur un lot de 8 requêtes. Sur un lot de 1 024 requêtes, la diffusion répond en 4,21 secondes contre près de 50, soit 12 à 20 fois plus vite selon la taille du lot.
Ce que l’étude ne dit pas sur Google Search
Ni le billet ni l’article ne citent AI Mode ou les AI Overviews, et l’on n’y lit aucune mention de Google Search. Seul pont, dans le billet : le lien posé sur l’expression query fan-out mène à l’annonce d’AI Mode de mars 2025. Un lien de définition, pas un déploiement.
Le terrain d’essai est étroit : deux catalogues fermés, 142 472 articles de mode tirés de Polyvore et 8 522 playlists encodées avec MuLan. Jamais le Web. Or les auteurs écrivent eux-mêmes que l’entraînement coûte cher pour des bases très volumineuses ou changeantes. Le Web cumule les deux.
La vitesse a un prix. Sur Polyvore, la version rapide issue de Gemma affiche un rappel légèrement inférieur à celui de Gemini 2.5 Flash (15,0 contre 15,7) pour une diversité supérieure (46,2 contre 33,4). Celle issue de Qwen3 dépasse Gemini en rappel. Une partie de la qualité est aussi jugée par un modèle de langage, limite que l’article reconnaît.
Reste ce que Google a confirmé, et ce qui demeure ouvert.
| Établi | Non établi |
|---|---|
| AI Overviews et AI Mode peuvent recourir au fan-out (documentation Search Central). | L’emploi de R4T dans l’un de ces produits. |
| AI Mode lance « une douzaine de recherches » le temps d’en faire une (Dounia Berrada, mars 2026). | Le nombre exact de sous-requêtes, et leur formulation. |
| Deep Search peut en lancer des centaines (Google I/O 2025). | La part des recherches qui déclenchent un fan-out. |
| Aucun réglage particulier n’est requis pour apparaître dans ces fonctionnalités (Search Central). | Un effet de R4T sur la visibilité d’une page. |
Notre lecture : à gauche, un besoin de vitesse ; à droite, aucune règle de référencement qui change aujourd’hui.
Sous-requêtes redondantes, pages redondantes : la lecture SEO
Ce qui suit est une lecture d’ExternFlow, pas une conclusion des auteurs. Si un système récompense la diversité des résultats, deux pages qui répondent à la même facette se disputent une seule place. D’où une règle en quatre mots : une facette par URL.
Une donnée de terrain va dans ce sens. Elle vient de l’étude Surfer, relayée par Search Engine Land en décembre 2025, sur 173 902 URL. Une page positionnée sur des sous-requêtes y gagne 161 % de chances en plus d’être citée. Le sujet prolonge notre analyse des pages citées dans les AI Overviews.
Deux limites : c’est une corrélation, et les 33 000 sous-requêtes ont été produites avec Gemini, faute d’accès à celles du moteur. Or la version rapide de R4T n’en écrit aucune. L’écart entre simulation et système réel ne peut que grandir.
Un garde-fou pour la règle d’une page par intention d’achat, tirée de l’étude Evocia sur les citations de ChatGPT. Elle tient si chaque page apporte un fond propre : des données, un cas, des critères, des sources que les autres n’ont pas. Des pages « par intention » qui se paraphrasent couvrent une seule facette.
Une interprétation, à prendre comme telle : l’ancrage pesant plus de la moitié de la note, le système vise ce qui existe déjà dans son index. Une facette que personne ne couvre reste inexplorée.
R4T agit enfin au stade de la récupération, et d’autres étapes trient encore avant la citation. Récupérer une page ne veut pas dire la citer.
Mesurer la redondance de vos contenus avant d’en commander d’autres
Le test repère les contenus redondants en cinq étapes, avec un outil que beaucoup d’équipes SEO possèdent déjà.
- Réunir 10 à 30 pages publiées sur un même sujet.
- Calculer leur similarité sémantique avec Screaming Frog, version 22 ou suivante (rapport « Semantically Similar », plongements OpenAI, Gemini ou Ollama).
- Calibrer le seuil sur deux pages que vous savez redondantes et deux que vous savez distinctes. Le seuil par défaut de 0,95 ne repère que les quasi-doublons.
- Regrouper les pages au-dessus du seuil : chaque groupe compte pour une facette.
- Comparer le nombre de pages au nombre de facettes, puis fusionner, différencier ou retirer.
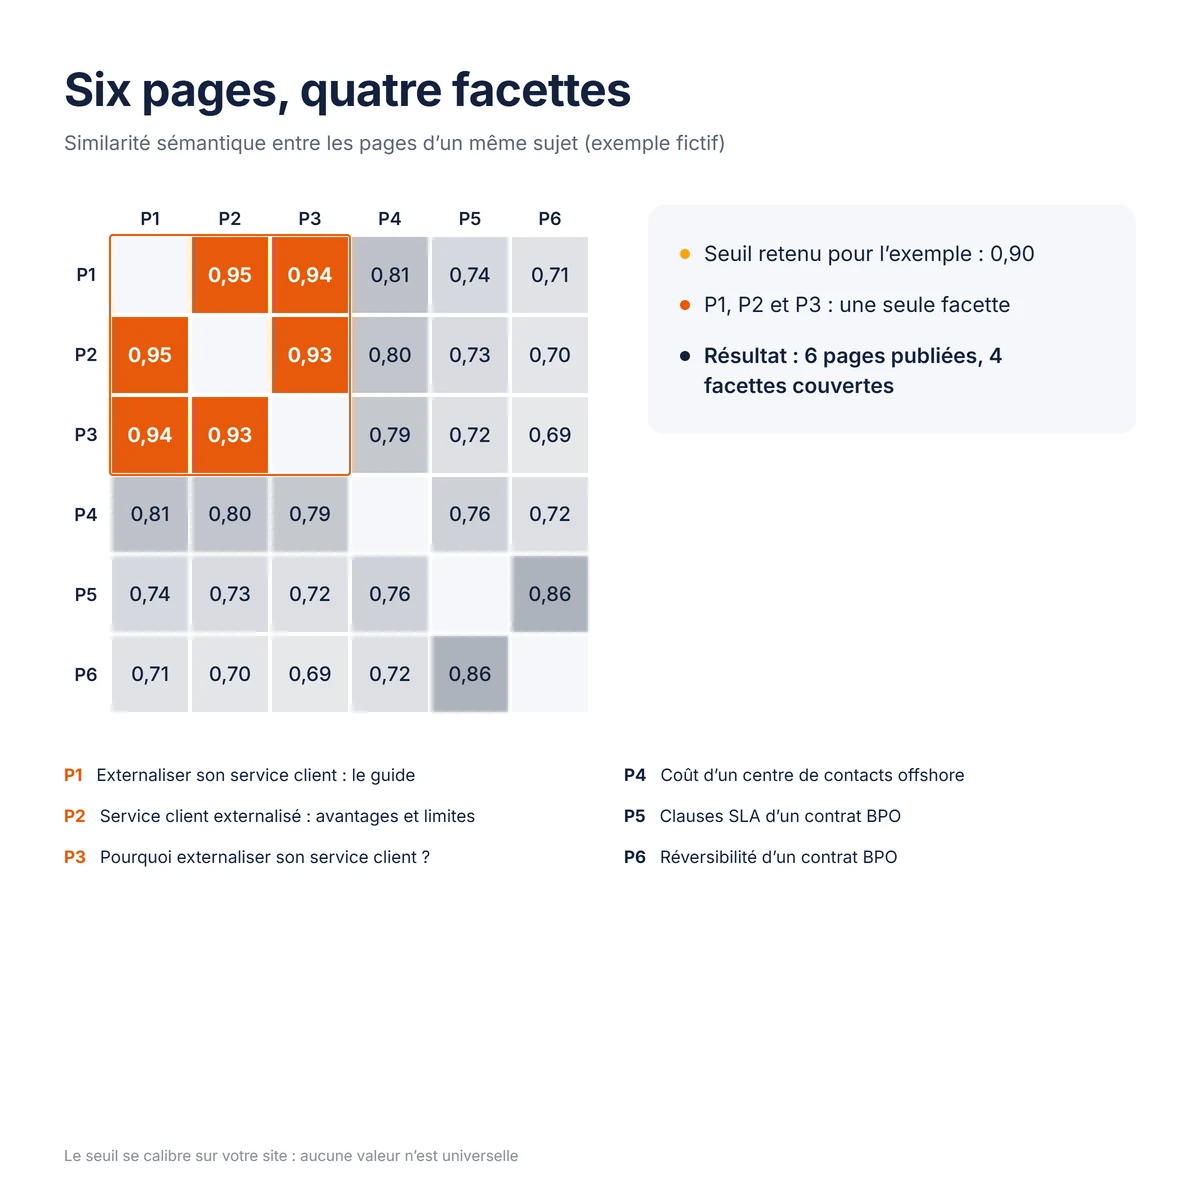
Calculé tel quel, le Vendi Score sous-estime les facettes quand les textes viennent d’un même site. D’où le seuil calibré.
La grille de R4T se transpose à chaque page du groupe. Répond-elle à l’intention commune, apporte-t-elle une facette absente des autres, est-elle indexée et prouvée ? Pour relier ensuite les pages conservées, l’architecture en cocon sémantique face aux moteurs génératifs reste le bon cadre.
La similarité mesure la proximité des textes, pas leur utilité : il faut relire à la main chaque regroupement avant toute fusion.
Externaliser la production sans payer des variantes
Un prestataire payé à l’article a intérêt à multiplier les pages voisines. C’est l’effondrement paraphrastique à l’échelle d’un calendrier éditorial. Nul besoin de mauvaise foi pour y arriver : un sujet qui marche appelle sa variante.
Trois règles d’achat suffisent à le contenir.
- La carte des facettes appartient au client et se met à jour à chaque commande.
- Toute nouvelle URL nomme la facette qu’elle ajoute, dès le brief adapté aux moteurs agentiques.
- Le test de redondance figure au cahier des charges, avec son seuil.
C’est la condition pour externaliser son SEO sans en perdre le contrôle : le prestataire écrit, vous gardez la carte.
Compter ses facettes avant de commander ses articles
Le signal à surveiller est précis : l’annonce d’un fan-out plus rapide dans un produit Google, ou une ligne nouvelle dans la documentation Search Central. Au 18 septembre 2026, rien de tel. Pour le savoir sans y passer vos matinées, inscrivez-vous à La lettre ExternFlow.
D’ici là, une décision ne dépend d’aucune annonce : passer un groupe de pages au test avant toute nouvelle commande.
Sources et références
Cet article s’appuie notamment sur l’article de recherche de Jiang et de ses dix coauteurs sur la récupération en éventail compilée par renforcement, déposé sur arXiv en mars 2026 et sur le billet de Google Research du 15 septembre 2026 qui présente Retrieve-for-Train. Le fonctionnement du fan-out dans les produits de recherche est documenté par la page Search Central consacrée aux fonctionnalités d’IA et à votre site, par l’annonce faite à Google I/O 2025, qui décrit Deep Search, par l’annonce initiale d’AI Mode de mars 2025, vers laquelle pointe le billet, et par l’entretien de Dounia Berrada, directrice de l’ingénierie de la recherche, sur la recherche visuelle dans AI Mode. La mesure de diversité vient de l’article de Friedman et Dieng qui définit le Vendi Score. Pour le test, nous avons consulté la note de version 22.0 de Screaming Frog sur la similarité sémantique, et pour la donnée de terrain le compte rendu par Search Engine Land de l’étude Surfer sur les sous-requêtes et les AI Overviews.
FAQ - Questions sur le query fan-out et Retrieve-for-Train
Qu’est-ce que le query fan-out dans la recherche Google ?
C’est la technique par laquelle AI Mode et les AI Overviews peuvent lancer plusieurs recherches liées sur des sous-thèmes et des sources de données différentes, avant de composer une seule réponse. Elle est décrite dans la documentation Search Central. La même page précise qu’aucune exigence supplémentaire ne conditionne la présence d’un site dans ces fonctionnalités.
Retrieve-for-Train est-il déjà utilisé dans Google AI Mode ?
Rien ne l’indique. Ni le billet ni l’article de recherche ne décrivent un déploiement dans le moteur de recherche, et les tests portent sur un catalogue de mode et un catalogue de playlists. La méthode relève pour l’instant de la recherche publiée.
Qu’appelle-t-on l’effondrement paraphrastique d’un modèle de langage ?
C’est la tendance d’un modèle à produire des variantes d’un même sens au lieu d’explorer des facettes distinctes. Pour « tenue de festival bohème », il écrit « mode festival bohème » puis « vêtements festival bohème », et passe à côté de la veste à franges ou de la robe en crochet.
Faut-il fusionner les pages qui traitent la même facette d’un sujet ?
Souvent, mais après avoir contrôlé le trafic et les liens de chaque page. Si les deux ont une audience, mieux vaut différencier leur fond que retirer l’une d’elles. Une fusion s’accompagne toujours d’une redirection 301 de l’URL retirée vers l’URL conservée.
Les outils qui affichent les sous-requêtes de Google sont-ils fiables ?
Ils donnent une idée des thèmes voisins, pas une copie du système : le moteur ne publie pas ses sous-requêtes, et ces outils simulent un modèle de langage. Dans la version rapide de R4T, les pistes de recherche prennent même la forme de vecteurs, sans aucun texte à afficher.
La lettre ExternFlow
Chaque semaine, une sélection d’analyses sur le BPO, l’externalisation et le SEO, pensée pour les décideurs. Pas de publicité, pas de revente d’adresse.
Cet article vous a été utile ?
Ajoutez ExternFlow à vos sources préférées sur Google
Par Setraniaina Andrianajason
Je suis Setraniaina, fondateur de LAPLUME.MG et consultant SEO/GEO indépendant via Red Island SEO, depuis Madagascar. Passionné de nouvelles technologies, d'IA et de marketing digital, je partage sur ExternFlow mes analyses sur l'externalisation, le BPO et le référencement.