Tracking server-side et données first-party : faut-il revoir votre mesure marketing ?
Le suivi marketing devient plus fragile lorsque les navigateurs, les bloqueurs, le consentement et les plateformes publicitaires limitent la donnée disponible. Le tracking server-side promet un meilleur contrôle, mais il exige aussi une vraie gouvernance technique, juridique et analytique.

Sommaire
- Qu’est-ce que le tracking server-side ?
- Pourquoi GA4 et les pixels publicitaires montrent-ils leurs limites ?
- Quels bénéfices attendre d’une architecture server-side ?
- Données first-party : de quoi parle-t-on réellement ?
- Le tracking server-side permet-il de contourner le consentement ?
- Quand le server-side devient-il pertinent pour une PME ?
- Que demander à un prestataire analytics avant de signer ?
- Mieux mesurer ne signifie pas tout collecter
- Sources et références
- FAQ - Questions sur le tracking server-side
Un formulaire est rempli, le CRM crée une opportunité, puis la vente se conclut trois semaines plus tard. Dans GA4, la session existe. Dans Google Ads ou Meta, la conversion peut être attribuée autrement. Dans le logiciel commercial, la source a parfois disparu. Le problème n’est plus seulement de compter les clics, mais de relier des systèmes qui ne voient ni les mêmes événements ni la même période.
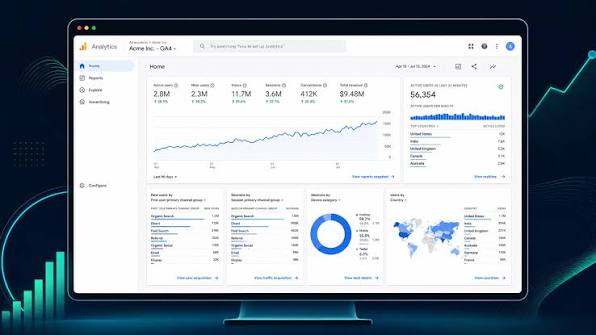
Se contenter de GA4 et des pixels publicitaires reste acceptable pour une mesure simple. Cela devient insuffisant dès que l’entreprise investit sérieusement dans l’acquisition, vend sur plusieurs canaux ou doit rapprocher les leads du revenu. La réponse n’est pourtant pas de supprimer les outils côté navigateur. Google précise lui-même que son Measurement Protocol doit compléter la collecte automatique, pas la remplacer. Cette collecte se lit désormais sur une page unique : le tableau de bord personnalisable de Google Analytics, limité à quinze cartes, oblige à choisir les indicateurs qui décident.
Le bon débat oppose donc moins le client-side au server-side qu’une mesure isolée à une architecture maîtrisée. Le navigateur capte l’interaction. Le serveur filtre, enrichit et distribue. Le CRM ou le système de commande confirme l’issue commerciale. C’est cette chaîne qu’il faut décider, documenter et contrôler.
Qu’est-ce que le tracking server-side ?
Dans un dispositif classique, des scripts chargés dans le navigateur envoient directement des événements vers GA4, Google Ads, Meta ou d’autres plateformes. Une vue de page, un ajout au panier ou un formulaire déclenche alors une requête depuis le terminal de l’utilisateur. C’est le tracking client-side.
Avec le tracking server-side, le navigateur ne dialogue plus nécessairement avec chaque destination. Il transmet d’abord les données à un point de collecte géré par l’entreprise ou pour son compte. Ce serveur reçoit l’événement, applique des règles, puis envoie aux plateformes uniquement les informations prévues.
| Interaction | Collecte web | Point de contrôle | Destinations | Référence business |
| Clic, vue, formulaire, achat | Tag web ou application | Conteneur server-side sur domaine dédié | GA4, Google Ads, Meta, entrepôt de données | CRM, commande, marge, statut du lead |
Dans Google Tag Manager, les « clients » du conteneur serveur reçoivent les requêtes et les traduisent en événements exploitables. Les tags appliquent ensuite les règles d’envoi. La documentation d’introduction au server-side tagging de Google décrit ce rôle d’adaptateur entre le terminal, le conteneur et les outils de destination.
Le mot « serveur » peut toutefois prêter à confusion. Il ne désigne pas forcément une machine installée dans vos locaux. Le conteneur peut fonctionner dans Google Cloud, chez un autre hébergeur ou sur une infrastructure administrée par un prestataire. La vraie question est ailleurs : qui possède le compte cloud, le domaine, la configuration, les journaux et la documentation ?
GA4 server-side n’est pas une nouvelle version de GA4
GA4 reste une destination d’analyse. Le conteneur server-side est une couche de collecte et de routage placée en amont. Il peut envoyer un même événement vers GA4, une plateforme publicitaire et un entrepôt de données, après avoir retiré ou transformé certains paramètres.
Autre mécanisme, le Measurement Protocol de GA4 permet d’envoyer directement des événements serveur à serveur, par exemple une vente hors ligne ou une action réalisée après la visite. Google avertit qu’une implémentation entièrement serveur ne donne accès qu’à une partie du reporting. Des identifiants comme client_id, session_id ou app_instance_id restent nécessaires pour rattacher correctement les événements.
Autrement dit, un serveur ne reconstitue pas automatiquement ce qui n’a jamais été défini. Si « lead_qualifie » n’existe pas dans le plan de mesure ou si le CRM n’enregistre pas la source, déplacer les tags ne règle rien.
Pourquoi GA4 et les pixels publicitaires montrent-ils leurs limites ?
GA4 répond à des questions d’audience et de comportement. Google Ads et Meta répondent à des questions d’optimisation propres à leurs campagnes. Le CRM répond à des questions commerciales. Aucun de ces outils n’est, seul, une vérité exhaustive.
Le client-side rencontre plusieurs fragilités connues :
- un script peut ne pas se charger à cause d’un bloqueur, d’une erreur ou d’une connexion interrompue ;
- une navigation peut se terminer avant l’envoi de l’événement ;
- les politiques des navigateurs réduisent la durée ou l’usage de certains identifiants ;
- un consentement refusé limite légitimement les données disponibles ;
- deux pixels peuvent compter différemment la même conversion ;
- une vente conclue dans le CRM n’est pas toujours renvoyée vers la campagne d’origine.
Le dernier point est souvent le plus coûteux en B2B. Une demande de démonstration n’a pas la même valeur qu’un contrat signé. Tant que les plateformes optimisent sur le formulaire, elles privilégient les profils qui remplissent facilement un champ, pas nécessairement ceux qui achètent. La stratégie marketing B2B doit donc relier les canaux au pipeline et au revenu, au lieu de s’arrêter au volume de leads.
Les plateformes proposent déjà des réponses partielles. Google Ads utilise les Enhanced Conversions pour rapprocher une conversion de données first-party fournies par l’utilisateur, comme une adresse électronique, après hachage SHA-256. Meta recommande d’utiliser sa Conversions API avec le pixel afin de réduire la dépendance aux erreurs de chargement et aux bloqueurs. Dans les deux cas, la donnée serveur complète le signal du navigateur. Elle ne rend pas la plateforme indépendante de votre plan de mesure.
Quels bénéfices attendre d’une architecture server-side ?
Le premier gain est le contrôle des flux. Au lieu de laisser chaque tag collecter ses propres paramètres dans la page, l’entreprise peut définir une liste autorisée. Le conteneur reçoit l’événement, retire une information inutile, renomme un champ, calcule une valeur ou réserve certaines données à une seule destination.
La qualité peut aussi progresser. Un identifiant de transaction commun aide à dédupliquer un achat envoyé par le navigateur et par le serveur. Un statut CRM permet de distinguer le lead reçu du lead qualifié. Une base de commandes fournit une valeur réellement facturée, plus fiable qu’un montant reconstruit dans la page de confirmation.
Les bénéfices raisonnables sont les suivants :
- moins de scripts exécutés dans la page, donc un potentiel gain de performance si les tags sont réellement déplacés ;
- un point de filtrage central, utile pour contrôler les paramètres transmis à chaque fournisseur ;
- des événements serveur ou hors ligne, comme une vente, un renouvellement ou une qualification commerciale ;
- une meilleure cohérence des identifiants, des noms d’événements et des valeurs de conversion ;
- une collecte plus observable, grâce aux journaux, aux erreurs HTTP et aux tests du conteneur ;
- une activation first-party plus structurée, quand le CRM, l’e-commerce et les plateformes partagent des règles communes.
Google avance également des gains de performance et de sécurité dans sa présentation officielle du server-side tagging. Il faut lire ces promesses comme des capacités, pas comme des résultats automatiques. Un conteneur mal configuré peut dupliquer des conversions, divulguer trop de paramètres ou tomber en panne sans alerte.
Le server-side ne produit pas non plus une attribution « vraie ». GA4, Google Ads et Meta conservent leurs modèles, leurs fenêtres et leurs règles. Une hausse des conversions rapportées après migration peut signifier une récupération de signal, une meilleure mise en correspondance ou un doublon. Elle doit être comparée aux commandes, à la marge et au pipeline, pas célébrée seule.
Données first-party : de quoi parle-t-on réellement ?
Les données first-party sont collectées directement dans la relation entre l’entreprise et ses clients ou prospects. Elles incluent les formulaires, commandes, comptes utilisateurs, inscriptions, conversations commerciales, renouvellements, retours produits et statuts du CRM. Elles sont plus proches du résultat business que les audiences louées à une plateforme.
Le terme ne signifie pas « librement exploitable ». Une donnée obtenue directement reste soumise à une finalité, une base légale, une durée de conservation, une information des personnes et des règles de sécurité. Son transfert vers une régie publicitaire constitue un traitement distinct à cadrer.
Le hachage mérite la même prudence. Une adresse électronique transformée en empreinte SHA-256 n’est pas nécessairement anonyme. Si elle peut être rapprochée d’un compte ou d’informations supplémentaires, elle reste une donnée personnelle pseudonymisée. Le Comité européen de la protection des données rappelle explicitement que la pseudonymisation ne fait pas sortir la donnée du RGPD.
Une politique first-party sérieuse commence donc par trier les données :
- celles nécessaires au fonctionnement du service et à la facturation ;
- celles utiles à l’analyse agrégée de la performance ;
- celles utilisées pour attribuer ou optimiser une campagne ;
- celles envoyées à une plateforme pour mise en correspondance ;
- celles qui ne devraient jamais quitter le CRM ou le système métier.
Cette classification permet d’appliquer une règle simple : une destination reçoit ce dont elle a besoin, pas tout ce que le serveur connaît.
Le tracking server-side permet-il de contourner le consentement ?
Non. Le changement d’itinéraire technique ne change ni la finalité publicitaire ni les règles applicables aux traceurs. La CNIL rappelle que les pixels invisibles, identifiants et mécanismes de lecture ou d’écriture sur le terminal entrent dans le champ des traceurs. Sauf exemption, le consentement doit être recueilli avant leur utilisation, avec un refus aussi simple que l’acceptation.
Le Consent Mode ne recueille pas ce consentement. Il transmet aux tags l’état choisi par l’utilisateur afin qu’ils adaptent leur comportement. La documentation Google sur le Consent Mode avec un conteneur serveur exige toujours une solution de consentement ou une bannière compatible. Le conteneur doit recevoir et respecter le signal.
Meta formule la même limite pour sa Conversions API : elle n’est pas conçue pour contourner les politiques de partage, le cadre européen ou les choix des utilisateurs. Cette précision figure dans la documentation officielle de la Conversions API.
Le server-side peut même aggraver le risque si l’entreprise l’utilise pour rendre la collecte moins visible. Côté navigateur, un audit repère assez vite les requêtes vers les régies. Côté serveur, l’envoi peut devenir opaque pour l’utilisateur, le responsable marketing et parfois le délégué à la protection des données. D’où l’importance de documenter les destinations, les paramètres, les finalités et les durées.
Si un prestataire héberge le conteneur ou accède aux journaux, il faut aussi cadrer la sous-traitance, les accès et les éventuels transferts. La checklist ExternFlow sur l’externalisation et le RGPD détaille les garanties à vérifier lorsqu’un fournisseur traite des données hors de l’Union européenne.
Quand le server-side devient-il pertinent pour une PME ?
Une petite entreprise n’a pas besoin d’une infrastructure complexe pour suivre dix formulaires par mois. Si le plan d’événements est encore flou, le CRM incomplet et les campagnes modestes, la priorité reste la qualité du socle client-side. Le server-side ajouterait un coût et une nouvelle zone de panne.
Le projet devient plus crédible lorsque plusieurs signaux se cumulent :
- l’acquisition payante représente un budget assez important pour que les écarts de mesure influencent les arbitrages ;
- le site e-commerce doit rapprocher paiement, remboursement, marge et campagnes ;
- le cycle B2B exige de renvoyer les leads qualifiés et les ventes hors ligne ;
- plusieurs plateformes reçoivent aujourd’hui des événements incohérents ;
- les pertes de signal sont mesurées, pas seulement supposées ;
- l’entreprise veut filtrer précisément les données envoyées à chaque fournisseur ;
- une personne interne peut rester propriétaire du plan de mesure et des accès.
Avant de lancer, mesurez un état initial pendant quatre à six semaines : volumes par événement, écarts entre commandes et plateformes, taux de qualification des leads, erreurs, consentement par catégorie et temps de chargement. Sans cette référence, impossible de savoir ce que la migration a amélioré.
Le budget cloud doit aussi être anticipé. Google recommande plusieurs instances pour la redondance en production et indique que le déploiement renforcé peut coûter plusieurs dizaines de dollars par serveur et par mois, hors trafic supplémentaire. Le prix réel dépend de l’architecture, du volume, de l’hébergement et de la supervision. La facture du prestataire ne doit donc pas masquer les coûts d’infrastructure.
Que demander à un prestataire analytics avant de signer ?
Le choix porte moins sur la capacité à créer un conteneur que sur la manière de le rendre exploitable dans deux ans. L’entreprise doit conserver la maîtrise des comptes, des secrets, du domaine et du plan d’événements. Externaliser l’implémentation ne revient pas à céder l’architecture, comme le rappelle la définition du BPO et de sa gouvernance.
| Sujet à cadrer | Question au prestataire | Preuve attendue |
| Propriété | À qui appartiennent le compte cloud, le domaine et les conteneurs ? | Accès administrateur au nom du client |
| Consentement | Comment le choix de l’utilisateur est-il transmis et testé ? | Matrice des états, captures et scénarios de refus |
| Données | Quels paramètres entrent, sortent ou sont supprimés ? | Dictionnaire d’événements et liste par destination |
| Déduplication | Comment évitez-vous le double comptage navigateur et serveur ? | Identifiants communs et tests d’achat ou de lead |
| Supervision | Qui surveille les erreurs, la capacité et les coûts ? | Alertes, journaux, seuils et responsable nommé |
| Réversibilité | Comment revenir au client-side ou changer d’hébergeur ? | Procédure de rollback, export et documentation |
Exigez aussi un plan de recette. Il doit couvrir l’acceptation, le refus et le retrait du consentement, les transactions répétées, les remboursements, les formulaires interrompus, les ventes hors ligne et les périodes de panne. La documentation Google recommande de contrôler les tags déclenchés et les erreurs dans le mode Preview. En production, la surveillance de l’infrastructure server-side doit suivre les réponses HTTP en erreur et les incidents de capacité.
Les KPI du prestataire doivent mesurer la fiabilité, pas gonfler les conversions : taux de requêtes en erreur, écarts entre source métier et destinations, part d’événements dédupliqués, délai de transmission, incidents, coût d’infrastructure et couverture documentaire. Le nombre de conversions récupérées reste un indicateur secondaire, à interpréter avec les ventes réelles.
Mieux mesurer ne signifie pas tout collecter
GA4 et les pixels publicitaires restent utiles. Ils ne suffisent plus lorsque l’entreprise leur demande d’expliquer seuls un parcours qui continue dans le CRM, le système de paiement, les magasins ou les échanges commerciaux. Le server-side ajoute alors un point de contrôle entre l’interaction et les plateformes.
Ce point de contrôle n’est pas une machine à récupérer toute la donnée perdue. Il sert à choisir ce qui est collecté, à transmettre le consentement, à dédupliquer les événements et à rapprocher la mesure d’un résultat métier. La valeur vient de cette gouvernance.
Commencez donc par un audit du plan de tracking : listez les conversions réellement utiles, leur source de vérité, les données nécessaires, les destinations autorisées et les écarts actuels. Si cette carte tient sur une page et qu’elle révèle un manque mesurable, le server-side peut devenir le bon investissement. Si elle n’existe pas, construisez-la avant d’ouvrir un compte cloud.
Sources et références
Cette analyse s’appuie sur la documentation Google Tag Manager consacrée au server-side tagging, sur le Measurement Protocol de Google Analytics, sur les guides relatifs aux conversions Google Ads côté serveur, aux Enhanced Conversions et au Consent Mode. Les limites juridiques ont été confrontées aux règles de la CNIL sur les cookies et traceurs, aux précisions du Comité européen de la protection des données sur la pseudonymisation et à la documentation Meta sur la Conversions API.
FAQ - Questions sur le tracking server-side
Qu’est-ce que le tracking server-side ?
Le tracking server-side fait transiter les événements par un serveur contrôlé par l’entreprise ou son prestataire avant leur envoi vers les outils d’analyse et de publicité. Cette couche peut filtrer, transformer, dédupliquer et distribuer les données selon des règles documentées.
Quelle différence avec GA4 classique ?
GA4 est un outil d’analyse et une destination de données, tandis que le server-side tagging est une architecture de collecte placée en amont. Les deux fonctionnent ensemble, et GA4 peut continuer à recevoir les événements issus du navigateur ou du serveur.
Le server-side tracking permet-il de contourner le consentement ?
Non, l’itinéraire serveur ne supprime ni l’obligation d’information ni le consentement exigé pour certains traceurs. Le dispositif doit transmettre et respecter le choix de l’utilisateur, puis limiter les données envoyées aux finalités autorisées.
Quand une PME doit-elle passer au server-side ?
Le projet devient pertinent lorsque les dépenses média, le volume e-commerce ou la complexité du cycle commercial rendent les écarts de mesure coûteux. Une PME doit d’abord disposer d’un plan d’événements stable, d’un CRM exploitable et d’une personne responsable des accès.
Quels risques existe-t-il avec un prestataire analytics ?
Les principaux risques sont la dépendance technique, la perte des accès, le surpartage de données, les doublons et l’absence de supervision. Le contrat doit prévoir la propriété des comptes, la documentation, les tests, les alertes et une procédure de retour arrière.
La lettre ExternFlow
Chaque semaine, une sélection d’analyses sur le BPO, l’externalisation et le SEO, pensée pour les décideurs. Pas de publicité, pas de revente d’adresse.
Cet article vous a été utile ?
Ajoutez ExternFlow à vos sources préférées sur Google
Par Setraniaina Andrianajason
Je suis Setraniaina, fondateur de LAPLUME.MG et consultant SEO/GEO indépendant via Red Island SEO, depuis Madagascar. Passionné de nouvelles technologies, d'IA et de marketing digital, je partage sur ExternFlow mes analyses sur l'externalisation, le BPO et le référencement.